
En bref : SEO Tools for Excel est un module payant qui récupère des données SEO directement dans Excel : balises meta, titre H1, code réponse, nombre de liens. Sa formule XPathOnUrl, entièrement personnalisable, permet de scraper n’importe quelle donnée d’une page.
Formules Onsite de SEO Tools For Excel
Comme je le disais en introduction, le module SEO Tools for Excel offre un certain nombre de formules déjà toutes écrites qui vous permettront de récupérer toutes sortes de données intéressantes pour le SEO. Je n’aborderai ici que mes formules préférées qui concernent le SEO onsite, mais il faut savoir que l’outil permet également de récupérer de la date offsite, via Majestic SEO notamment, ainsi que des données intéressantes pour des reportings (Google Analytics, Google Search Console, réseaux sociaux…). SEO Tools for Excel va donc nous permettre d’obtenir des données sur des URLs précises sans avoir besoin de relancer à chaque fois un crawl manuellement comme ça pourrait être le cas avec Screaming Frog. De plus, les data sont récupérées directement dans Excel et donc directement exploitables. Cela va donc vous faire gagner du temps et permettre de vérifier les informations de certaines pages sans avoir besoin de les visiter.Récupérer des informations sur les balises Meta
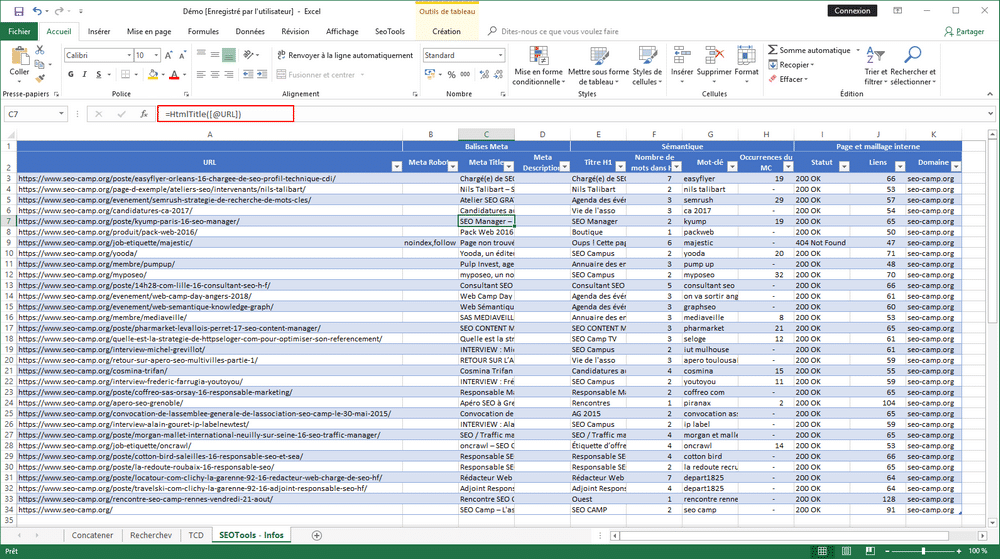
En premier lieu, voici les formules que je préfère et qui concernent les balises meta : la meta robots, la meta title et enfin la meta description Meta robots :=HtmlMetaRobots([@URL])
Meta Title :
=HtmlTitle([@URL])
Meta Description :
=HtmlMetaDescritpion([@URL])
Couplé à une formule =NBCAR pour compter le nombre de caractères, cela permettre de rapidement constater les balises meta qui doivent être raccourcies / remplies. Egalement, un petit =SI permettra de comparer la balise à la version soumise au client afin de valider la bonne implémentation des recommandations.
Récupérer des informations sur la sémantique
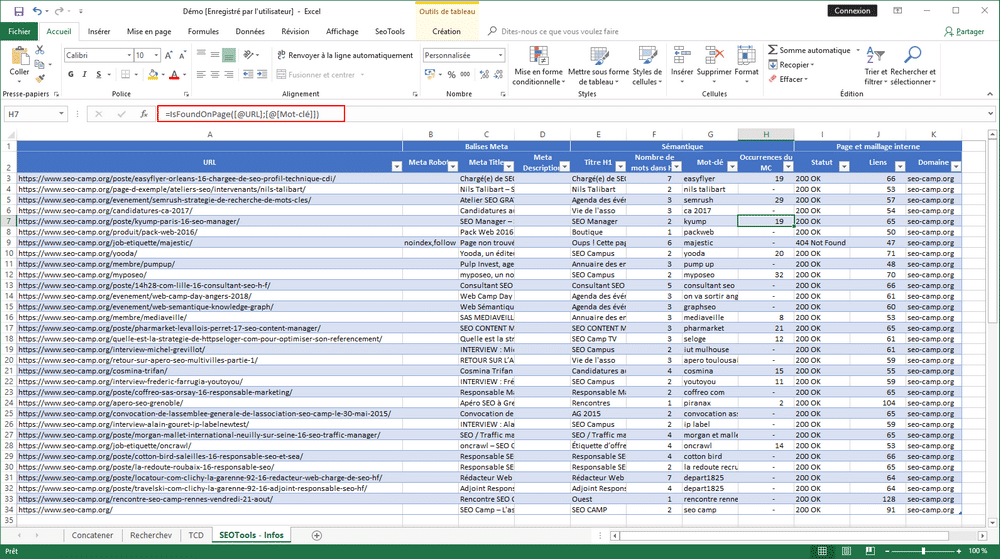
Egalement, SEO Tools for Excel permet de récupérer certaines informations sur la sémantique des pages, notamment le titre H1 et le nombre d’occurrences d’un mot-clé sur une page. Autre formule indispensable, un compteur de mots, puisque Excel ne propose nativement que de compter le nombre de caractères. Titre H1 :=HtmlH1([@URL])
Nombre d’occurrences d’un mot-clé sur une page :
=IsFoundOnPage([@URL];[@[Mot-clé]])
[@URL] : URL à crawler
[@[Mot-clé]] : Mot-clé à rechercher dans la page
=CountWords([@[Titre H1]])
On voit dans cet exemple que j’ai couplé le titre H1 et le compteur de mots d’une cellule. Ainsi, on peut très rapidement identifier les pages à optimiser pour le référencement naturel. Egalement, la non présence sur la page du mot-clé principal permet de détecter des soucis d’optimisation, mais aussi de la sur-optimisation si le nombre est trop important.
Récupérer des informations sur la page et le maillage interne
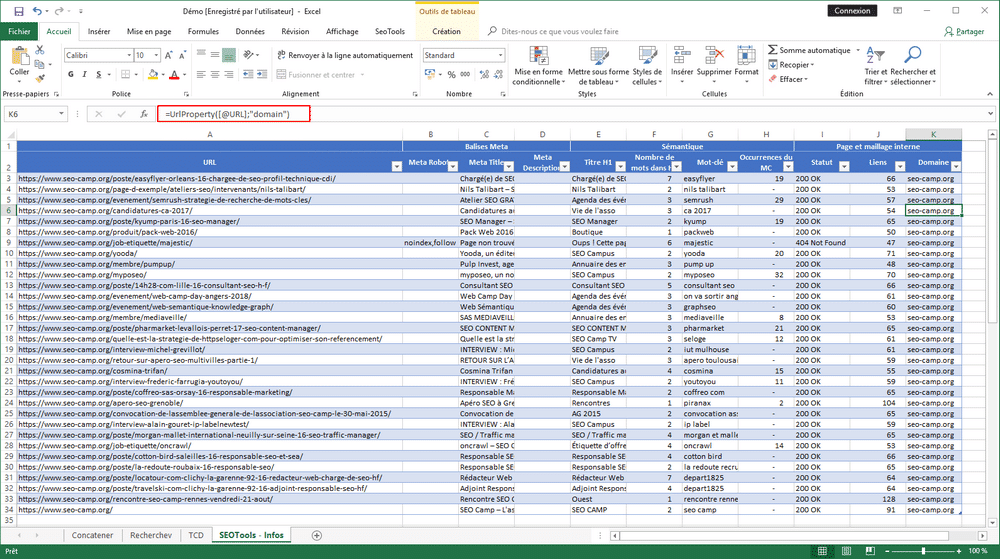
Enfin, dans la liste des formules que j’utilise quotidiennement dans le cadre de mon travail de consultante SEO, on en retrouve propre au domaine et au statut de l’URL. Je couple souvent ces formules à un export de crawl Screaming Frog, afin d’actualiser mes données et d’obtenir plus de précisions dessus. Statut (code réponse) :=HttpStatus([@URL])
Très utile pour avoir le statut en temps réel, pour tester la mise en place de redirections 301 par exemple. D’autre part, cela fonctionne également sur les préprod puisque SEO Tools for Excel utilise votre ordinateur et votre connexion. Enfin, cette formule HttpStatus permet également de suivre les chaînes de redirection pour identifier celles qui sont existantes et comment les corriger.
Nombre de liens présents sur la page :
=LinkCount([@URL])
Domaine :
=UrlProperty([@URL];"domain")
[@URL] : URL à crawler
"domain" : pour rechercher le domaine, ou "host" pour obtenir le sous-domaine
XPathOnUrl : Scraper une page pour en récupérer n’importe quelle donnée
Si dans les formules déjà existantes de SEO Tools for Excel vous ne trouvez pas votre bonheur, pas d’inquiétude ! Il existe une autre formule, XPathOnUrl, qui permet de scraper une page et d’en récupérer n’importe quelle donnée, pourvu qu’on ait situé dans quelle balise elle se trouve. Ainsi, vous pourrez facilement vérifier la bonne implémentation soumises et même faire de veille concurrentielle. Cette formule est particulièrement utile pour les sites à forte volumétrie, en e-commerce notamment. Cela permettra de scraper toutes les URLs d’un même type (page de produit, page de catégorie…). Et concrètement, comme on fait ?=Xpathonurl(N1;"//N2[@N3='N4']//N5";"N6")
N1 : Cellule dans laquelle se trouve l'URL à scraper
N2 : Type de balise dans laquelle se trouve le contenu à récupérer (ex : div, ul...)
N3 : Type d'identifiant qui va permettre de déterminer quelle balise doit être scrapée (ex : id, class...). Dans l'idéal, essayer de récupérer l'id qui est unique.
N4 : Identifiant ou classe en fonction du N3
N5 : Facultatif - Type de contenu à récupérer (ex : p, a...)
N6 : Facultatif - Partie du contenu à récupérer si il y a besoin de segmenter (ex : href...)
XPathOnUrl : Récupération du nombre d’articles par catégorie e-commerce
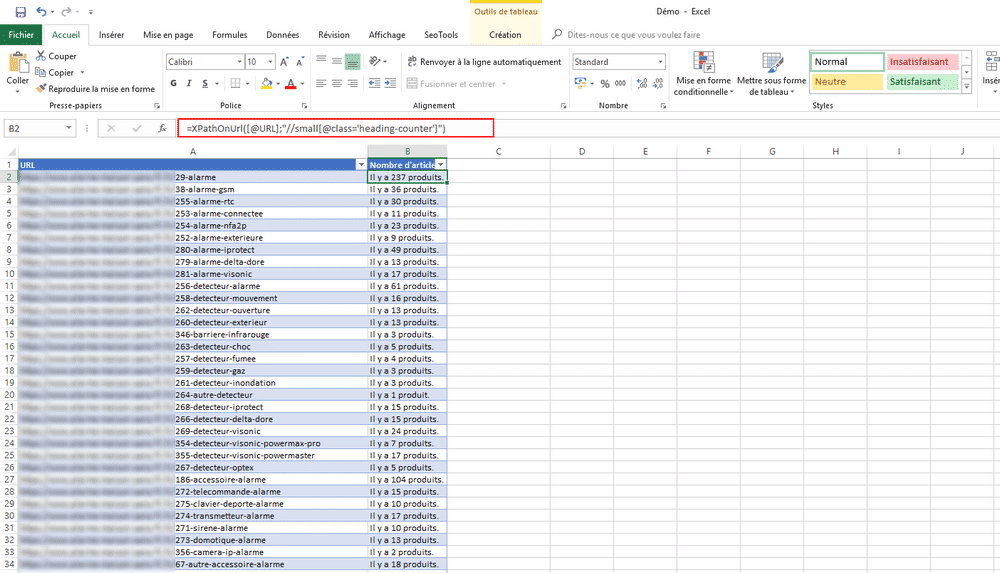
Voici le cas d’un site e-commerce avec un certain nombre de catégories e-commerce. On a besoin de les crawler pour identifier les catégories qui n’ont pas de produit et qui sont donc non pertinentes pour le SEO, et celles qui ont trop de produits et pourraient être plus segmentées. Pour commencer, il faut donc ouvrir un fichier Excel avec les URLs de catégorie dans un tableau. Ensuite, ouvrez une page de catégorie et repérez là où se trouve le nombre d’articles par page. Faites un clic droit sur la données à récupérer et cliquez sur « Inspecter » (sur Chrome, ou « Examiner l’élément » sur Mozilla Firefox). Repérez là où on retrouve cette donnée dans le code. Enfin, personnalisez la formule XPathOnUrl.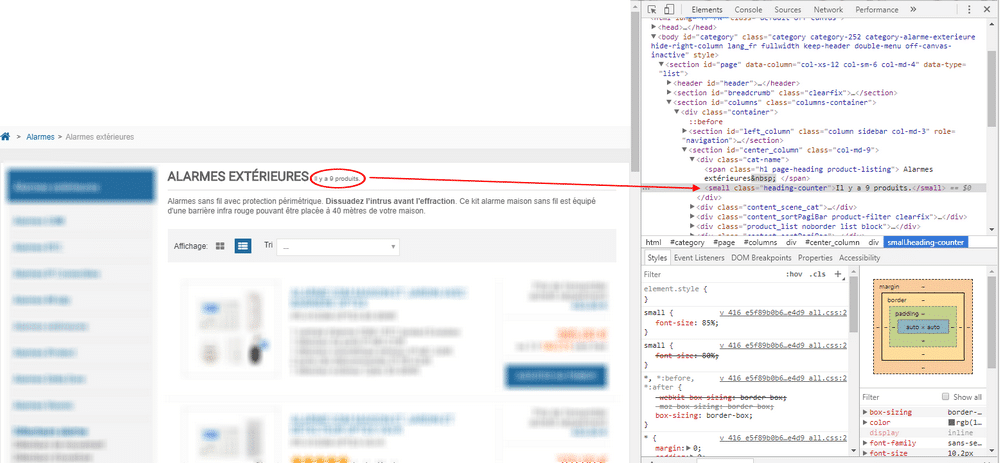 Ici, on voit que la donnée qui nous intéresse, « Il y a 9 produits », de trouve dans une balise small dont la classe s’appelle « heading-counter ». Il faut donc mettre cela dans la formule XPathOnUrl :
=XPathOnUrl([@URL];"//small[@class='heading-counter']")
[@URL] : URL à scraper
small : Balise dans laquelle se situe le nombre d'articles
class : Identifiant de la balise small
heading-counter : Contenu de l'identifiant de la balise small
XPathOnUrl : Récupération des introductions de catégorie d’un e-commerce
Maintenant que nous avons identifié les catégorie vides, il faut les optimiser sémantiquement. On va donc les scraper à nouveau pour récupérer les introductions de catégorie. Ainsi on pourra identifier celles qui n’en ont pas et qu’il va falloir optimiser. Dans le fichier Excel avec la liste des URLs de catégorie, insérez une nouvelle colonne. Allez sur une page de catégorie, repérez où se situe l’introduction de catégorie et faites un clique droit pour cliquer sur « Inspecter » dessus sur Chrome (toujours « Examiner l’élément sur Mozilla Firefox). Identifiez la balise dans laquelle se trouve l’introduction de catégorie pour personnaliser la formule XPathOnUrl.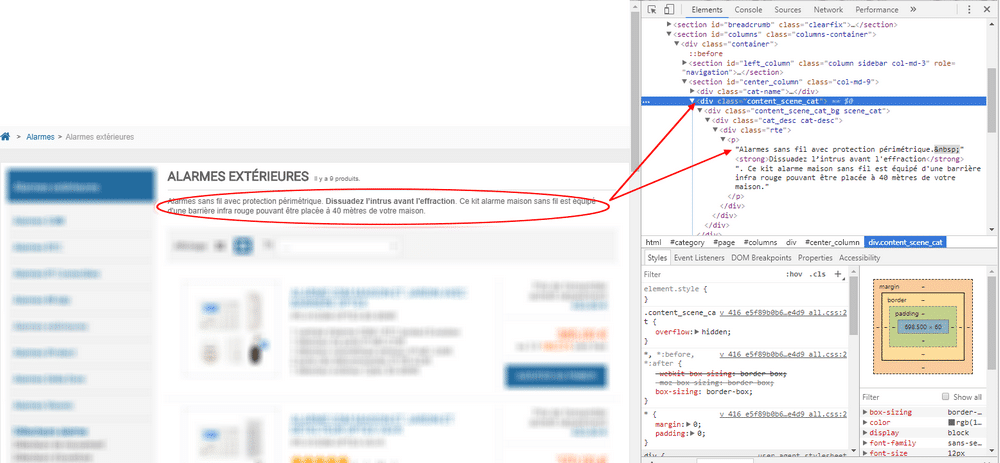 Ici, on voit que l’introduction de catégorie se situe dans une balise div dont la classe s’appelle « content_scene_cat ». La formule XPathOnUrl va donc être celle-ci, sachant qu’on va la mettre dans une DUMP pour relancer la formule autant de fois que nécessaire (sinon, seulement le premier paragraphe va ressortir sur Excel).
=DUMP(XPathOnUrl([@URL];"//div[@class='content_scene_cat']//p"))
[@URL] : URL à scraper
div : Balise dans laquelle se situe l'introduction de catégorie
class : Identifiant de la balise div
content_scene_cat : Contenu de l'identifiant dans la balise div
p : donnée à récupérer au sein de la balise sélectionnée
DUMP : pour relancer la fomule pour trouver toutes les données demandées
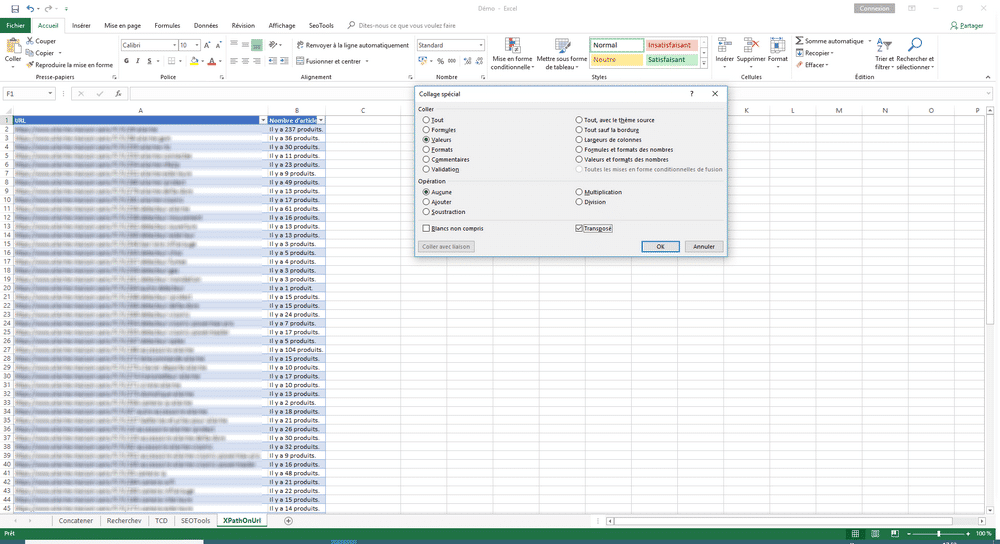 Pour commencer, on copie le tableau de base, et on le colle en transposé (clic droit > collage spécial > Cocher « Transposé).
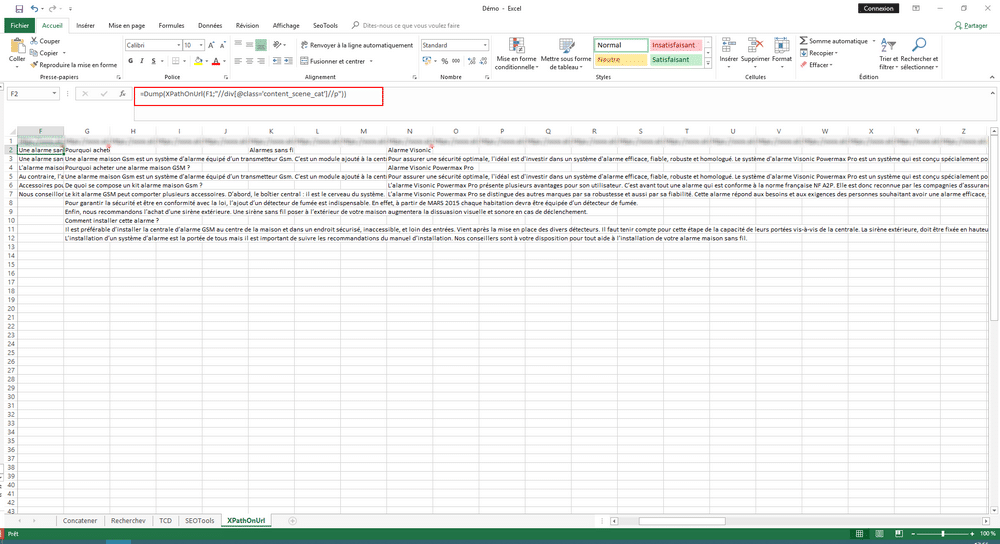 Ensuite on applique la formule XPathOnUrl définie plus haut, au sein d’une DUMP. On voit dans l’impression d’écran ci-dessus que les différents paragraphes s’affichent dans des lignes consécutives.
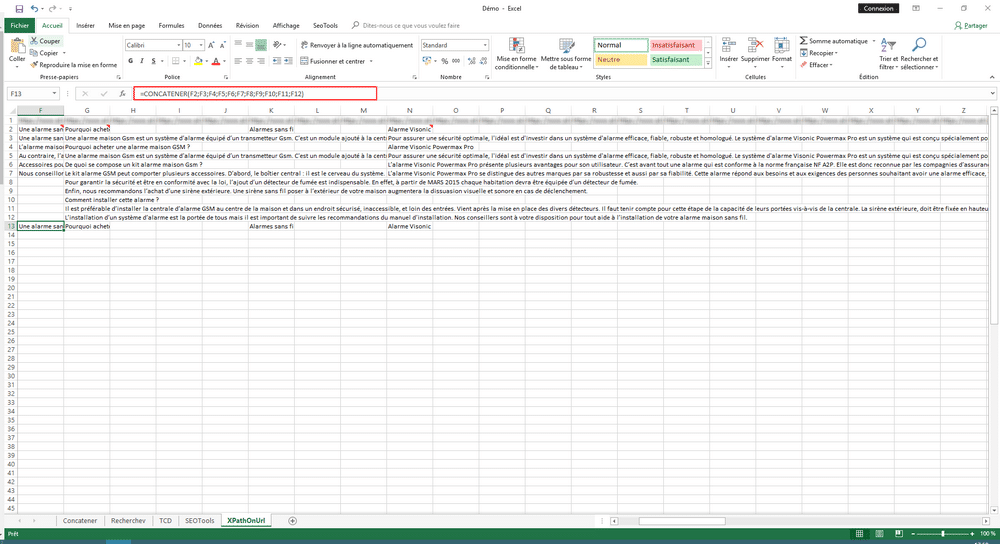 Puis on réunit toutes les lignes dans la même cellule afin d’avoir l’introduction de catégorie entière dans une même cellule, tous paragraphes réunis. On fait donc une formule CONCATENER (voir première partie de la conférence) reprenant toutes les cellules situées au-dessus.
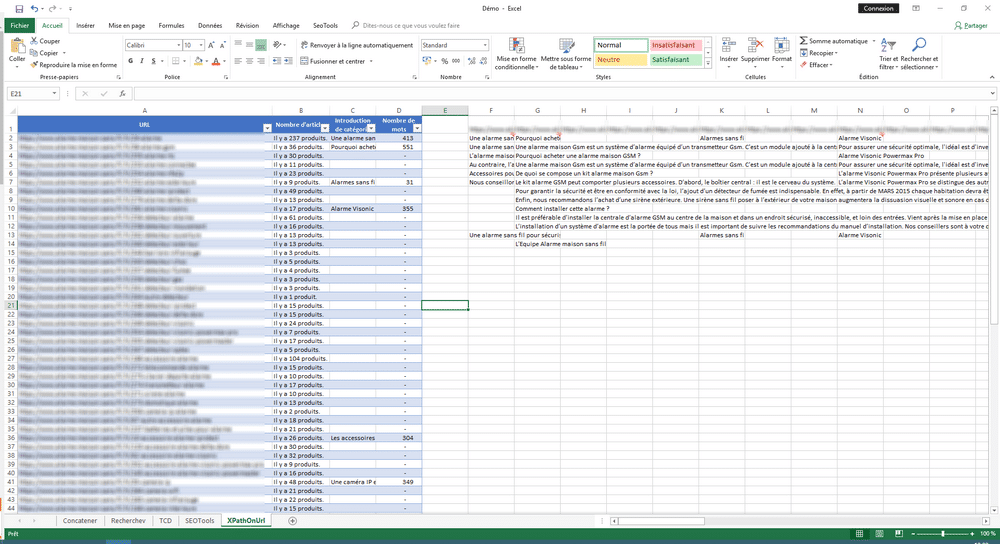 Enfin, dans le sens inverse, on copie les cellules concaténées et on les colle dans le premier tableau. Ainsi, vous avez l’introduction de catégorie dans votre tableau initial, auquel vous pouvez ajouter une petit =CountWords (comme expliqué plus haut) pour avoir le nombre de mots dans l’introduction de catégorie.
Il ne vous reste plus qu’à les optimiser ! Vous pouvez également le coupler avec un =SI pour comparer aux introductions fournies au client afin de vérifier la bonne implémentation.
XPathOnURL : encore pleins d’autres possibilités…
La formule XPathOnUrl est personnalisable à l’infini. Voici pour finir deux autres exemples d’utilisation que j’en ai : Récupération de toutes les URLs de catégorie depuis un plan de site :=DUMP(XPathOnUrl([URL];"//ul[@class='tree']//a";"href"))
Récupération du fil d’Ariane d’une page (à récupérer également en tableau transposé pour éviter l’enchevetrement des données) :
=DUMP(XPathOnUrl([URL];"//ol[@itemtype='http://schema.org/BreadcrumbList']//li"))
Les deux formules citées ci-dessus sont comme les précédentes utilisables sur un prestashop 😉
Vous l’aurez compris, vous pouvez scraper n’importe quelle donnée d’une page avec XPathOnUrl. Comme j’ai eu l’occasion de le dire au SEO Camp Day Lyon 2018, « il n’y a pas d’autre limite que votre imagination ! »
D’autres articles parlent d’autres possibilités avec SEO Tools for Excel, notamment comment faire un crawl alternatif à Screaming Frog avec un article de Cédric Guerin (https://cedricguerin.fr/scraper-avec-excel/), et comment exporter les données de Majestic SEO avec un article de Korleon Biz (https://www.korleon-biz.com/seo-tools-for-excel.html).
A vous de jouer, et n’hésitez pas à partager vos XPathOnUrl et tips sur SEO Tools for Excel dans les commentaires.
Questions fréquentes
Qu’est-ce que SEO Tools for Excel ?
Un module pour Excel, désormais payant, avec une version d’essai de 14 jours. Il récupère des données SEO sur des URLs précises directement dans Excel, sans relancer un crawl à chaque fois, soit par des formules déjà écrites, soit par la formule XPathOnUrl, entièrement personnalisable. Il gère aussi des données offsite et de reporting.
Quelles formules SEO Tools for Excel utiliser pour l’analyse onsite ?
HtmlMetaRobots et HtmlTitle récupèrent la meta robots et le title d’une URL, une formule équivalente existe pour la meta description. Couplées à NBCAR, elles repèrent les balises à raccourcir ou à remplir. HtmlH1, IsFoundOnPage et CountWords servent à l’analyse sémantique, HttpStatus et LinkCount au statut de l’URL et au maillage.
À quoi sert la formule XPathOnUrl ?
XPathOnUrl scrape une page pour en récupérer n’importe quelle donnée, à condition de savoir dans quelle balise elle se trouve. Elle sert à vérifier la bonne implémentation de recommandations, à faire de la veille concurrentielle ou, sur un site e-commerce, à récupérer le nombre de produits ou l’introduction de chaque catégorie.
Comment écrire une formule XPathOnUrl ?
Il faut d’abord repérer la donnée dans le code de la page avec la fonction « Inspecter » du navigateur, puis renseigner dans la formule l’URL, le type de balise, son identifiant, id ou class, et si besoin l’élément à extraire. Pour récupérer plusieurs éléments, la formule s’emboîte dans un DUMP, sur un tableau transposé.
Pourquoi utiliser la formule HttpStatus dans Excel ?
HttpStatus donne le code réponse d’une URL en temps réel, ce qui sert à tester la mise en place de redirections 301 et à suivre les chaînes de redirection pour les corriger. Elle fonctionne aussi sur les préproductions, puisque SEO Tools for Excel passe par l’ordinateur et la connexion de l’utilisateur.